把本地代码仓库变成可发布的 WordPress 技术文档
给一个代码仓库写中文技术文档,难点通常不在“写”,而在三件事:结构要跟源码对得上、配图和排版要适配 WordPress 主题、代码改了之后要能判断哪些章节需要重写。文枢 DocSmith 把这三件事收进一个本地运行的单进程程序:扫描源码建立基线,调用 DeepSeek 产出分析与大纲,渲染封面与架构图,逐章写成 Markdown 落到项目的 publish-readme/ 目录,再通过 WXR 导入包或 WordPress REST API 发布。
它不依赖云端托管,所有源码上下文只在本机读取后发给 DeepSeek;产物是普通 Markdown 文件,可以进 Git,也可以直接贴进 JustNews 的编辑器。下面按“定位 → 架构 → 运行链路 → 核心实现 → 使用 → 配置 → 排错”的顺序说明。
项目定位与能力边界
DocSmith 面向的是“已有代码、缺文档、要发到 WordPress”的场景。它做的事可以拆成四段:
- 读源码:遍历项目目录,跳过
node_modules、.git、dist等目录,对文本文件计算 SHA-256,连同 Git 提交号一起存成快照(基线)。 - 做分析:把文件树和高分文件内容拼成上下文,交给 DeepSeek 输出技术栈、模块划分、架构层、核心流程、大纲,并判断该写成单篇还是系列。
- 写正文:按大纲逐章生成 Markdown,插入封面、架构图、流程图,写入
publish-readme/,覆盖前自动备份。 - 发布:导出 WXR(可选 Base64 内嵌图片),或走 REST API 上传媒体并创建/更新文章,默认草稿。
需要提前明确的边界:
| 边界 | 说明 |
|---|---|
| 运行平台 | 配图渲染依赖 Windows 自带的 PowerShell 与 System.Drawing,非 Windows 环境不可用,失败时回退 SVG |
| 模型依赖 | 分析、撰写、变更判断全部依赖 DeepSeek API,未配置 Key 时无法生成 |
| 变更检测范围 | 只跟踪文本源码文件,二进制资源变化不进入文档影响判断 |
| 发布默认状态 | 默认草稿,公开发布需要显式确认 |
| 服务暴露面 | 仅监听 127.0.0.1,并拒绝非本地 Origin 的写请求 |
settings.json 以明文保存 DeepSeek Key 与 WordPress 应用密码,位置由程序运行目录与 DOCSMITH_DATA 决定。不要把 data/ 目录提交到公开仓库,也不要在共享机器上长期保留凭据。
整体架构:五层单进程
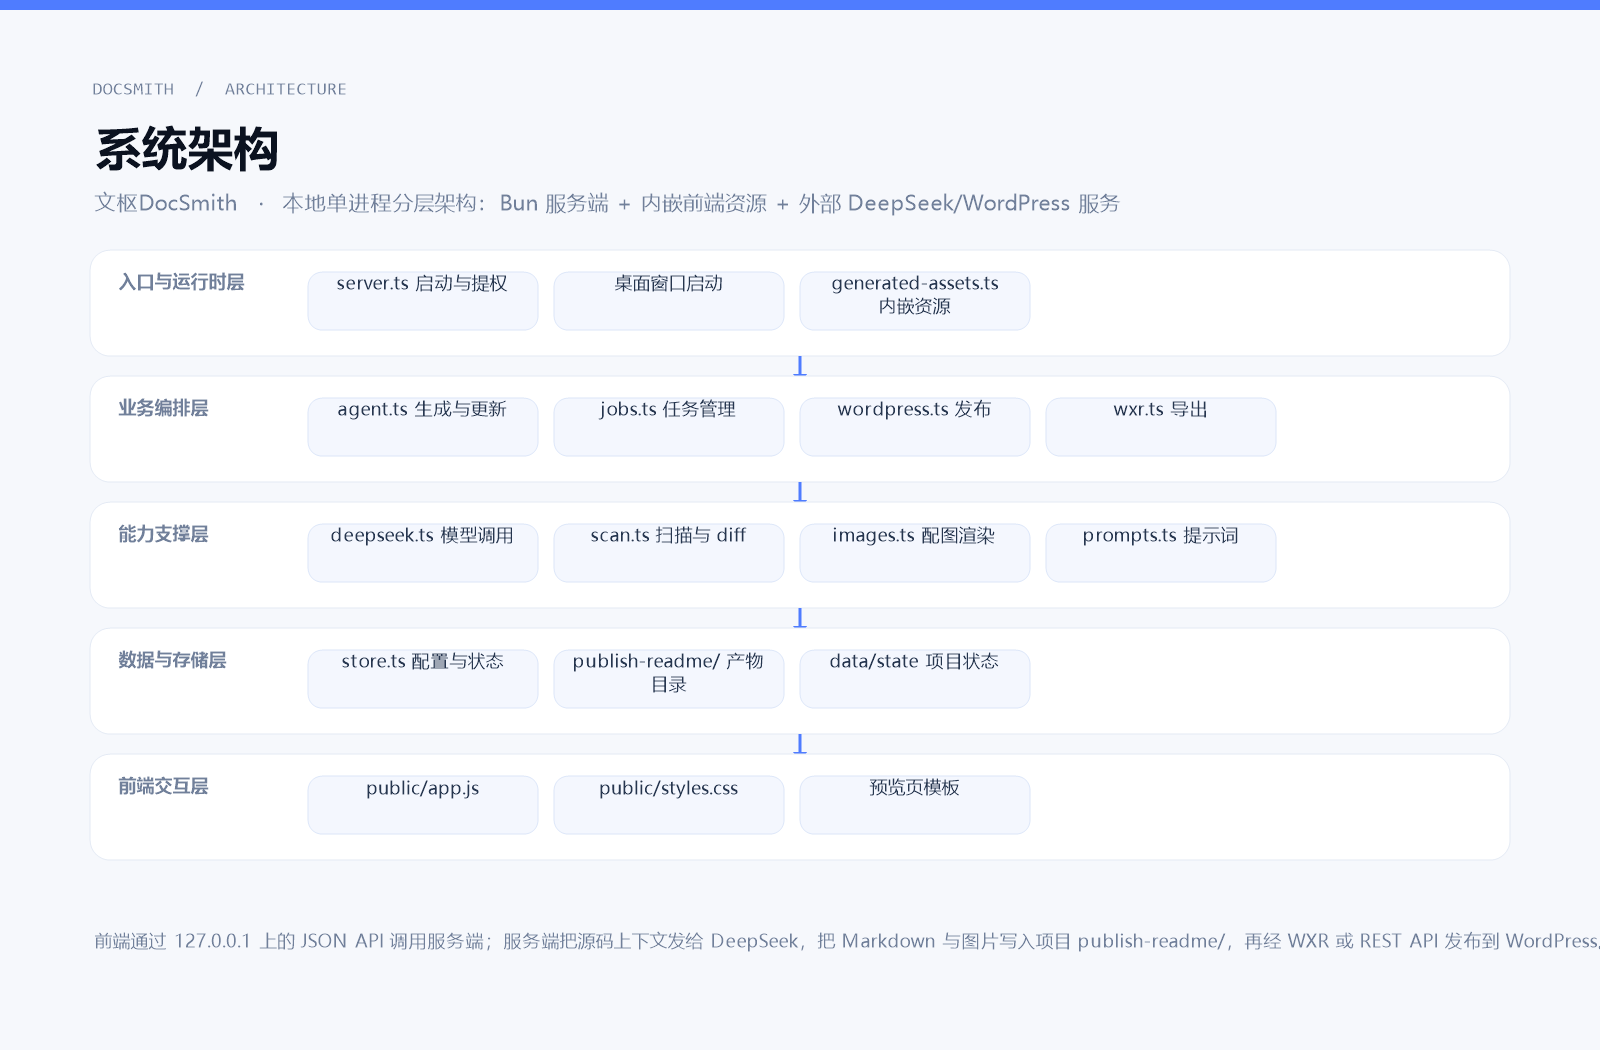
服务端是一个 Bun 进程,前端资源在构建时被内嵌进可执行文件,运行时通过 127.0.0.1 上的 JSON API 通信。分层如下:
| 层 | 主要文件 | 职责 |
|---|---|---|
| 入口与运行时 | src/server.ts、src/generated-assets.ts |
启动、提权、桌面窗口、路由、内嵌前端资源 |
| 业务编排 | src/agent.ts、src/jobs.ts、src/wordpress.ts、src/wxr.ts |
生成与更新、任务管理、发布、导出 |
| 能力支撑 | src/deepseek.ts、src/scan.ts、src/images.ts、src/prompts.ts |
模型调用、扫描与 diff、配图渲染、提示词 |
| 数据与存储 | src/store.ts、publish-readme/、data/state |
配置、项目状态、产物目录 |
| 前端交互 | public/app.js、public/styles.css |
编辑器、预览、设置、发布页、任务面板 |
src/server.ts 在启动阶段做了几件容易被忽略的事:把 console 重定向到 data/logs/docsmith.log,避免窗口隐藏后日志丢失;在 Windows 且非 Bun 运行时下尝试以管理员权限重启(可用 --no-elevate 或 DOCSMITH_NO_ELEVATE=1 关闭);随后 initStore() 初始化配置与项目列表。路由层统一用 json() / fail() 返回,写请求前用 localOrigin() 与 localHost() 校验来源。
前端资源不是运行时读文件,而是构建期产物。scripts/build-assets.ts 把 public/app.js、public/styles.css、index.html、favicon 打包成 src/generated-assets.ts 中的字符串常量,bun build --compile 再把它编进单文件可执行程序。这样分发时只需要一个 exe,不需要带 public/ 目录。
核心运行链路
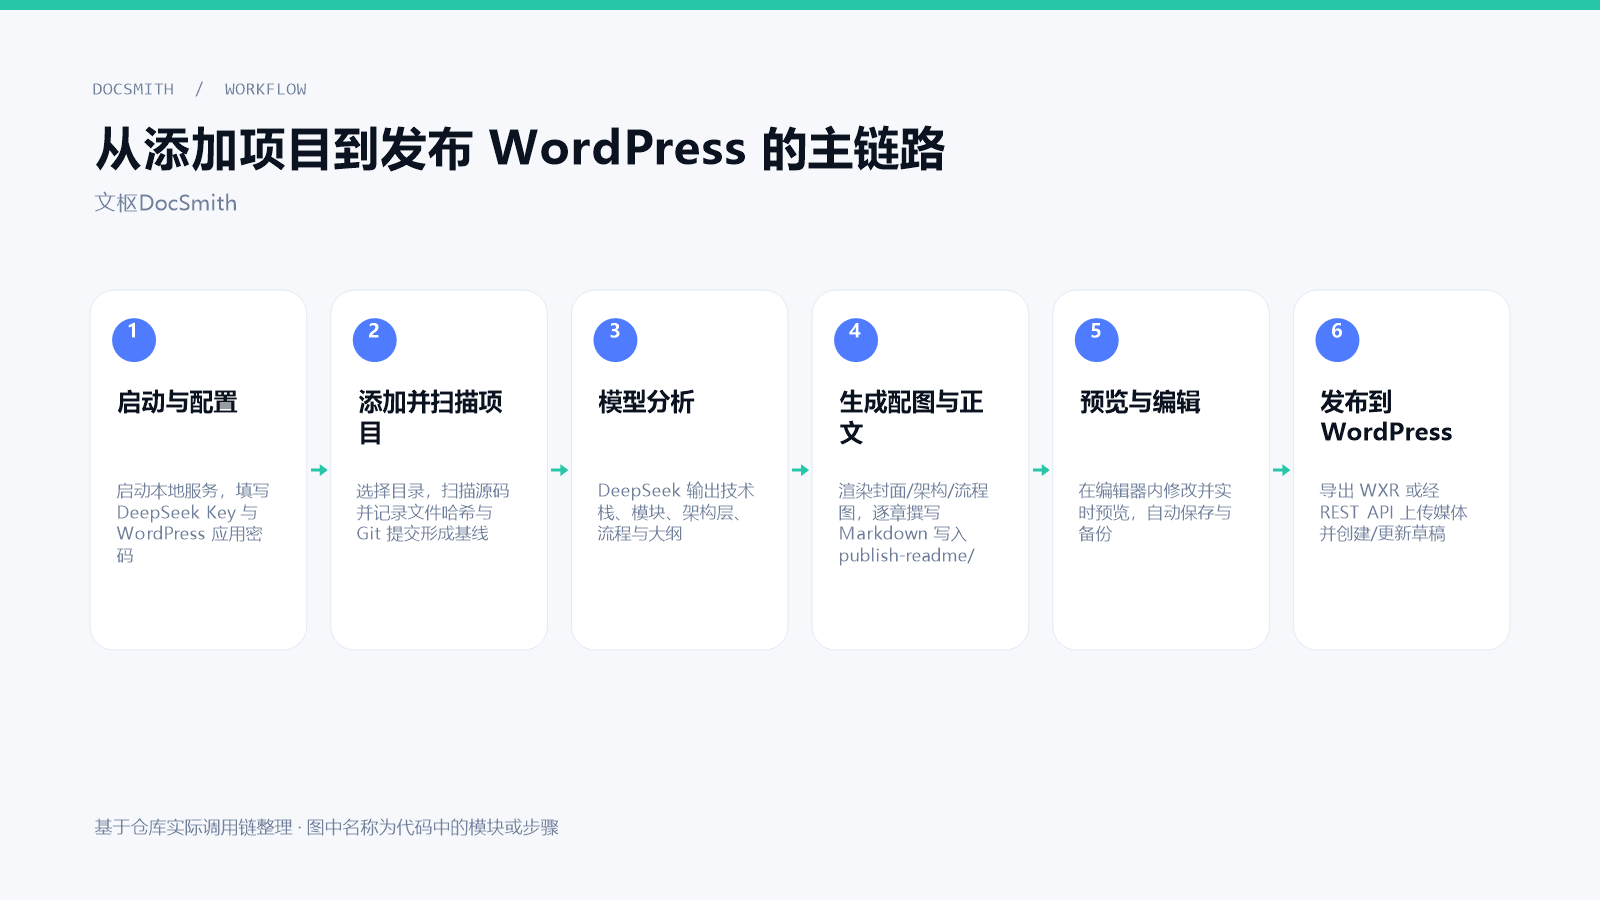
从添加项目到发布,主链路是六个阶段,每个阶段都有对应的状态落盘,中断后可以从项目详情恢复。
扫描与基线
scanProject() 用广度优先遍历目录,深度上限 14 层,文件数上限 16000,单文件超过 2 MB 跳过。候选文件由扩展名白名单(HASH_EXTENSIONS)和文件名白名单(TEXT_NAMES,如 dockerfile、makefile、package.json)共同决定。对每个候选文件读取字节、判断是否像文本、计算哈希:
// src/scan.ts(节选)
const stamps: Record<string, FileStamp> = {};
for (let i = 0; i < files.length; i += concurrency) {
  const slice = files.slice(i, i + concurrency);
  await Promise.all(slice.map(async (file) => {
    const data = await Bun.file(join(root, file.path)).arrayBuffer();
    const bytes = new Uint8Array(data);
    if (!isProbablyText(bytes)) return;
    stamps[file.path] = {
      hash: sha256(bytes),
      size: bytes.byteLength,
      mtime: Math.round((await stat(join(root, file.path))).mtimeMs),
    };
  }));
}
快照里同时记录 gitCommit 与 gitBranch(通过 git -C <root> rev-parse 获取,失败则为空)。这份快照就是后续增量更新的比较基准。
上下文构建
模型能看到的上下文是有限的,buildProjectContext() 用打分排序决定读哪些文件。打分规则在 scoreFile() 里:路径越浅分越高,README、package.json、tsconfig.json、vite.config.ts 等加 55 分,index/main/app/server/entry/cli/bootstrap 这类入口文件加 60 分,router/services/store/config 等目录加 24 分,测试、示例、静态资源目录减 28 分。排序后按预算逐文件读取,超出预算时截断最后一个文件。
buildFilesContext() 则用于“已知要读哪些文件”的场景(例如某章声明的 keyFiles),按给定路径读取并拼接。两者都通过 readProjectFile() 做路径越界检查(拒绝 ..)和大小限制。
分析与大纲归一化
DeepSeek 返回的 JSON 不能直接信任。normalizeAnalysis() 做了几层兜底:
- 模块和关键文件的
path必须存在于本次扫描到的文件集合中,否则置空丢弃; - 架构层为空时,用
features和模块名合成“接入层 / 核心层”; - 流程步骤为空时,填入“读取输入 → 执行核心逻辑 → 返回结果”;
- 大纲条目少于 2 条且模式为单篇时,强制收敛为一篇;
- 系列模式下大纲少于 3 条时,补“项目概览 / 架构设计 / 核心实现 / 使用指南”;
- slug 做正则校验与去重,重复时追加
-2、-3。
这一步的意义是:即使模型输出结构不完整,后续撰写流程也不会因为缺字段而中断。
配图渲染
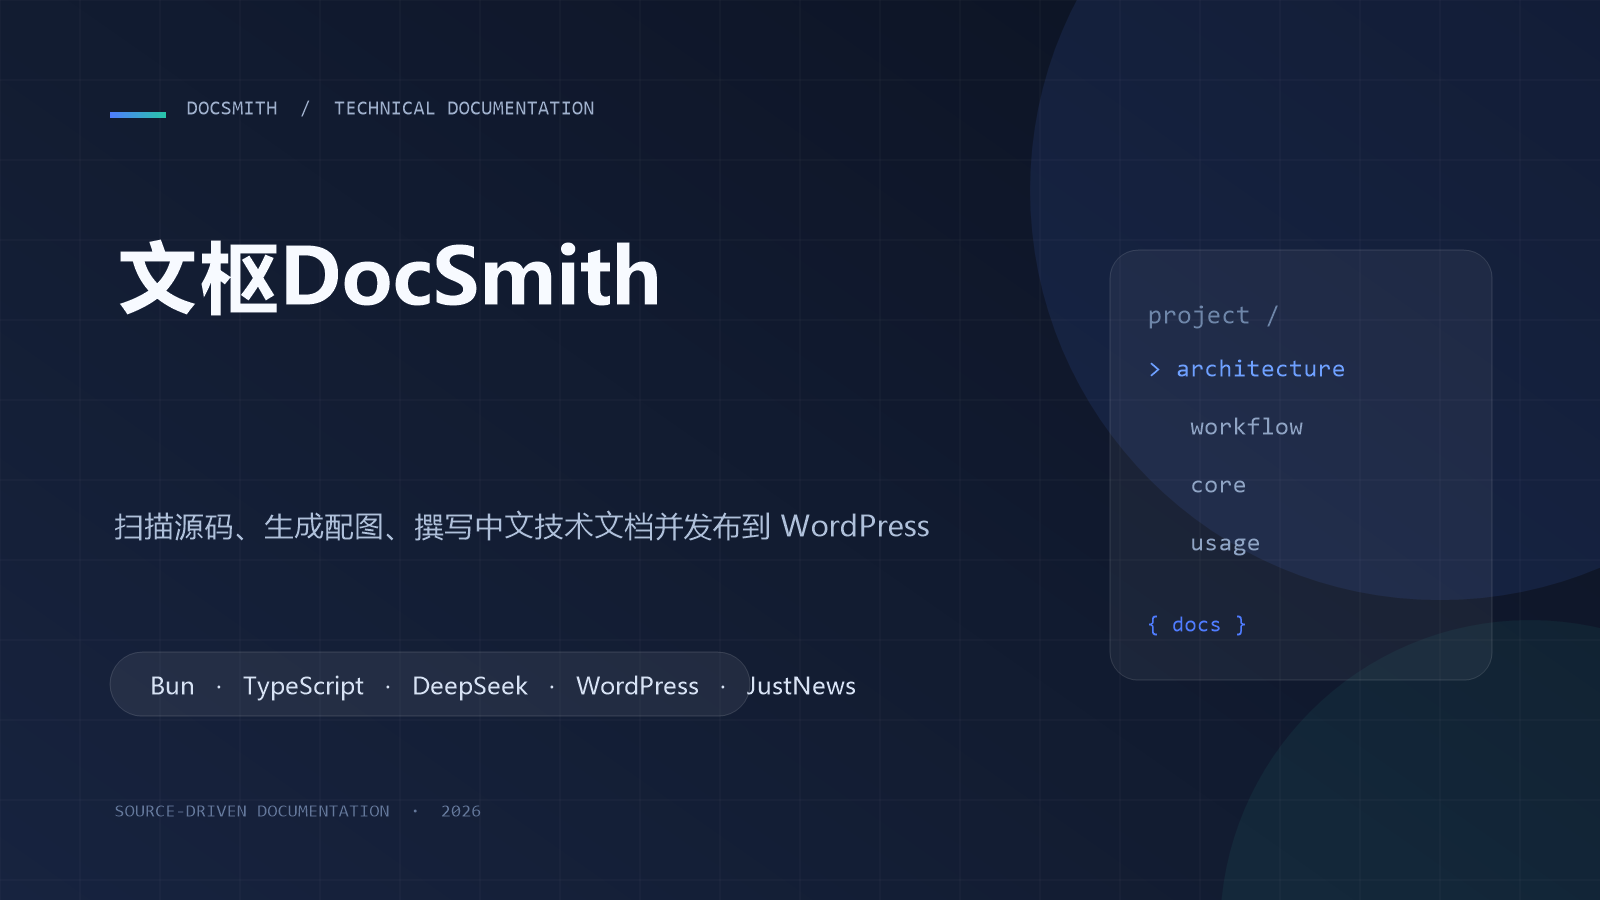
src/images.ts 先拼 SVG,再通过 PowerShell 调用 System.Drawing 渲染成位图,失败则保留 SVG。三种图各有模板:封面用深色渐变加代码面板装饰,架构图按层画卡片并用箭头连接,流程图按步骤横向排布。文件名带项目前缀,避免上传到 WordPress 媒体库后重名。
正文里图片的插入不是简单拼接。applyFigures() 先替换模型可能写出的 “ 占位符,再按规则补插:
- 封面插在首个二级标题之前(
insertAfterIntro); - 架构图优先插在“整体架构 / 系统架构 / 架构设计”这类二级标题之前,找不到就插在封面图之后;
- 流程图优先插在“核心实现 / 运行流程 / 工作流程”这类标题之前,找不到就依次退到架构图、封面图之后。
系列模式下只有声明了 figure: architecture 或 figure: flow 的章节才插图,避免每章重复。
逐章撰写与落盘
normalizeMarkdown() 负责清洗模型输出:去掉外层代码围栏、去掉 YAML 头、把第一个一级标题替换成章节标题、删除残留的 {{figure:}} 占位符、压缩多余空行。写入前对同名文件做备份,备份目录是 publish-readme/.backup/。
系列模式还会生成一个索引页,列出各章标题、链接和字数,并汇总总字数与预计阅读时长。
增量更新
源码变更后,diffSnapshots() 对比新旧快照,产出 added / modified / deleted 三个列表和一句摘要。buildGitDiff() 优先取 baseline.gitCommit..HEAD 的 diff 和工作区未提交 diff;没有 Git 时退化为变更文件清单。这份 diff 连同现有文档清单交给模型,由模型判断哪些文档受影响,再只重写受影响的章节。
纯格式化改动、锁文件变动通常不会触发正文更新,因为模型看到的是 diff 语义而不是文件哈希。如果确实需要强制重写,直接在编辑器里手动触发重新生成更可控。
模型调用与容错
src/deepseek.ts 把 chat/completions 封装成一个带重试的 chat()。默认 baseUrl 是 https://api.deepseek.com,会自动补 /chat/completions;默认模型 deepseek-chat,temperature 0.35,max_tokens 8192,单次超时 240 秒。
重试策略是显式的:
- HTTP 429 或 5xx,最多重试 4 次,间隔按
1200 * (attempt + 1)递增; - 返回内容为空且
finish_reason === "length",把max_tokens提高 2048 后重试(上限 8192); - 401 直接报“API Key 无效或已失效”,不重试;
- 网络类错误统一转成“无法连接 DeepSeek,请检查网络、代理或 API 地址”。
结构化输出用 response_format: { type: "json_object" },解析交给 parseJsonReply():先剥代码围栏,再截取第一个 { 到最后一个 } 之间的内容。解析失败会抛出带原文片段的错误,方便定位是模型跑偏还是提示词问题。
estimateTokens() 用中日韩字符数乘 1.05、其余字符除以 3.6 估算,用于在拼上下文时做预算控制,不追求精确。
发布通道:WXR 与 REST API
两条发布路径的差异需要先说清楚:
| 维度 | WXR 导入包 | REST API |
|---|---|---|
| 图片处理 | 不携带二进制,需 Base64 内嵌或手动上传媒体 | 自动上传媒体并回填 URL |
| 发布方式 | WordPress 后台“导入” | 直接创建/更新文章 |
| 适用场景 | 目标站点无法开放 REST、或需要人工审核 | 站点可访问、有应用密码 |
| 默认状态 | 由导入时的选择决定 | 默认草稿 |
REST 路径下,src/wordpress.ts 负责连接测试、诊断、媒体上传与文章创建/更新;src/server.ts 里的 startPublishJob() 把发布包装成任务,通过 jobs.ts 推送日志与进度,前端任务面板可以订阅并取消。发布状态、文章 ID 与媒体映射写回项目 state,下次更新时复用同一篇文章而不是重复创建。
公开发布需要显式确认(confirmPublic),默认只创建草稿。如果站点装了安全插件或固定链接配置异常,REST 可能返回 404,此时应先用诊断功能确认 wp-json 是否可达,而不是反复重试发布。
使用方法
启动与首次配置
Windows 下双击 DocSmith.exe 会尝试提权;如果只想用标准权限,运行 start-manual.cmd,或给 exe 加 --no-elevate。端口默认 4317,可用 --port= 或环境变量 DOCSMITH_PORT 覆盖;不想自动开浏览器就加 --no-open 或设 DOCSMITH_NO_OPEN=1。
首次进入后打开设置页,填写 DeepSeek Key 与 WordPress 站点信息,分别点“测试连接”。DeepSeek 测试会返回模型名、延迟和一段预览文本;WordPress 测试走 REST 连接检查。
添加项目并生成
- 在项目页选择本地代码目录,触发扫描,确认文件数与 Git 提交号。
- 点“分析”,等待模型返回技术栈、模块、架构层与大纲;单篇/系列的判断结果会显示在界面上。
- 点“生成”,任务面板会依次显示配图、逐章撰写的进度。产物写入
<项目>/publish-readme/。 - 在编辑器里修改,右侧实时预览,
Ctrl+S保存,工具栏可插入标题、代码块、表格等。
发布到 WordPress
- WXR:在发布页导出,得到 XML 与发布包 ZIP,后台“工具 → 导入”上传。需要图片随包走时勾选 Base64 内嵌。
- REST:填好站点地址、用户名、应用密码,选择分类与标签,点发布。默认草稿,确认无误后在 WordPress 里改为发布。
源码变更后的增量更新
改完代码后回到项目页点“扫描”,程序会显示新增/修改/删除的文件数。点“更新”,模型根据 diff 判断受影响文档并只重写这些章节,其余文件保持不动。
配置项与数据目录
settings.json 中的主要字段(前端通过 publicSettings() 只暴露是否已配置,不回传明文):
| 配置项 | 含义 | 默认/说明 |
|---|---|---|
deepseekBaseUrl |
DeepSeek API 地址 | https://api.deepseek.com |
deepseekModel |
模型名 | deepseek-chat |
deepseekKey |
API Key | 明文存储,界面只显示是否已配置 |
wpSiteUrl |
WordPress 站点地址 | 用于拼 REST 路径 |
wpUsername |
发布账号 | — |
wpAppPassword |
应用密码 | 明文存储 |
defaultStatus |
默认发布状态 | 草稿 |
maxContextChars |
单次上下文预算 | 影响读取文件数量 |
autoOpenBrowser |
启动后是否开浏览器 | 与 --no-open 共同决定 |
includeCode |
正文是否包含代码块 | 布尔 |
数据目录由程序运行位置与 DOCSMITH_DATA 决定,包含 settings.json、projects.json、各项目 state 文件、logs/docsmith.log。README 中出现的 C:\Users\zynet\DocSmith\data\ 是作者本机示例路径,不要照抄。
把 maxContextChars 调大能让模型看到更多源码,但会拉高单次调用成本与超时概率。项目文件多时,优先保证入口文件、配置文件、路由与服务层被读到,而不是平均分配预算。
常见问题与排错
启动后立刻退出,提示未获得管理员权限。 这是提权失败。改用 start-manual.cmd 以标准权限运行,或右键 exe 选择“以管理员身份运行”。日志在 data/logs/docsmith.log。
生成时报“模型返回的结构化结果无法解析”。 多为模型输出被截断或夹带解释文字。先确认 max_tokens 未被调得过低,再重试;持续失败可换回 deepseek-chat。
配图只有 SVG 没有位图。 说明 PowerShell 渲染失败,常见于非 Windows 环境或 System.Drawing 不可用。SVG 仍可正常插入正文与上传,不影响发布。
WordPress 发布返回 404。 先用诊断功能确认 wp-json 可达;检查固定链接是否设为“朴素”,以及安全插件是否拦截了 REST 写请求。
更新后某些章节没变。 检查变更是否只涉及二进制资源、锁文件或纯格式化。这类改动不会进入文本 diff,因而不会触发重写。
媒体库出现重复图片。 图片文件名带项目前缀,正常不会重名;若手动改过文件名,重新生成时会产生新文件,旧文件需在媒体库手动清理。
结论
DocSmith 的价值在于把“源码 → 结构化分析 → 配图 → Markdown → WordPress”串成一条可重复执行的链路,并用文件哈希快照把“哪些文档该更新”变成可计算的问题。落地时抓住四点即可:首次配置先测通 DeepSeek 与 WordPress 两条连接;生成后务必在编辑器里过一遍再发布;发布保持默认草稿,确认后再公开;源码变更后先扫描看 diff 摘要,再决定是否触发更新。遇到问题优先看 data/logs/docsmith.log 与 WordPress 诊断结果,而不是反复重试。
本文基于 文枢DocSmith 仓库当前实现整理。代码与配置以仓库为准;版本变化后请以实际源码为准。
主题测试文章,只做测试使用。发布者:zy,转转请注明出处:https://zynetc.top/?p=2026102736